
En octobre 2026, l'IA a trouvé en quelques heures une faille vieille de dix ans dans PHP. Faire corriger l'internet a pris des semaines.
Cet écart — entre la vitesse à laquelle une machine trouve une faille et le temps qu'il nous faut pour prouver qu'elle est vraiment corrigée — c'est là que se décide la défense agentique. Pas dans le modèle. Dans la preuve.
Deux boucles, deux vitesses très différentes
La découverte a été rapide. Wiz Research explique que ces failles dormaient dans le cœur de PHP depuis plus de dix ans, et que démontrer qu'elles étaient exploitables « exigeait une chaîne d'étapes exceptionnellement complexe, à la limite de ce que des chercheurs humains pouvaient accomplir ». Les modèles frontières ont « substantiellement abaissé cette barrière », et des exploits fonctionnels ont été adaptés à WordPress, Drupal et Joomla en quelques heures (Wiz).
La correction, elle, a été lente. Le 21 octobre, PHP a publié des correctifs pour deux CVE — CVE-2026-109618 et CVE-2026-109619, surnommées « php2shell » — dans les versions 8.5.12, 8.4.27, 8.3.36 et 8.2.35. La CISA a demandé aux organisations d'inventorier chaque installation PHP, de corriger en priorité les systèmes exposés à Internet, et de mettre hors ligne les systèmes non corrigés (CISA).
Trois autres incidents sont survenus le même mois, et chacun pointait le même point faible : une autorité de certification dont les clés étaient si faibles qu'elles se cassaient en millisecondes, une chaîne de publication qui a livré un malware alors que le code source restait propre, et des banques découvrant des agents IA à l'intérieur de comptes clients.
Quatre échecs très différents. Un seul manque commun : personne ne pouvait prouver que la boucle était fermée.
Ce que j'appelle une preuve de fermeture
Une preuve de fermeture (closing proof) est quelque chose qu'une machine peut vérifier, et qui montre que l'état dangereux a disparu. Une sonde qui ne fonctionne plus. Une signature qui correspond. Une action restée dans le mandat déclaré. Une télémétrie qui montre que le confinement tient vraiment.
Sans elle, une alerte « traitée » n'est qu'une alerte cachée.
Règle 1 — Mesurer la correction, pas la réaction
Le MTTR indique la vitesse de réaction des humains. Il ne dit rien sur la fin du risque. Le chiffre qui compte, c'est le temps entre la découverte et la fermeture vérifiée.
Et cela impose un vrai choix : qui fixe le niveau d'autonomie — l'agent, ou le référentiel ?
Ma réponse : c'est le type de preuve qui décide de la porte.
| La preuve disponible | Exemple | Qui valide |
|---|---|---|
| Vérifiable par machine | La sonde échoue après le correctif ; la révocation atteint les clients | L'agent clôt, un humain audite après (HOTL) |
| Exige du jugement | Périmètre d'un incident, impact d'affaires, exception de dépendance | Un humain approuve avant l'action (HITL) |
eMudhra est l'exemple net du premier cas. Huit certificats intermédiaires portaient des clés privées de 4, 56, 66, 115, 155, 156, 230 et 237 bits, là où P-384 en attend environ 384. Les chercheurs les ont cassées en millisecondes, et les navigateurs les ont bloqués « en un jour ou deux » (Ars Technica). La boucle s'est fermée partout dans le monde sans humain au milieu, parce que la preuve — la révocation qui atteint le client — est vérifiable par une machine.
Un SOC, lui, convoque encore une réunion avant d'isoler un portable. Ce n'est pas de la frilosité. L'effet d'un isolement ne peut tout simplement pas être prouvé par une machine seule.
On retrouve le même clivage ailleurs. L'Adaptive Thinking d'Anthropic laisse le modèle décider de sa profondeur de raisonnement. Le Reasoning Effort d'OpenAI impose à l'opérateur de la fixer (none à xhigh). L'un fait confiance à l'auto-régulation, l'autre à un paramètre déclaré. Les auditeurs préfèrent généralement le second.
Sur le terrain. En télécom, un service répond ou ne répond pas : la fermeture est vérifiable par machine sur le parc inventorié. Sur un port, corriger le système de commande d'un portique ne se confirme qu'en exploitation — donc un humain signe. La porte suit le terrain, pas la doctrine.
detection { # Detection
n1: circle label:"Start"
n2: rectangle label:"Inventory the real exposure"
n3: rectangle label:"Rank by observed exploitation"
n1.handle(right) -> n2.handle(left)
n2.handle(right) -> n3.handle(left)
n3.handle(bottom) -> remediation.n4.handle(top) [label="Prioritised estate"]
}

remediation { # Remediation
n4: rectangle label:"Deploy the patch"
n5: diamond label:"Patch applies"
n6: rectangle label:"Enable a temporary mitigation"
n7: rectangle label:"Log outcome and due date"
n4.handle(right) -> n5.handle(left)
n5.handle(right) -> n7.handle(top) [label="yes"]
n5.handle(bottom) -> n6.handle(top) [label="no"]
n6.handle(right) -> n7.handle(bottom) [label="mitigation"]
n7.handle(bottom) -> assurance.n8.handle(top) [label="Estate state"]
}

assurance { # Assurance
n8: rectangle label:"Replay the validation probe"
n9: diamond label:"Proof is machine-checkable"
n10: rectangle label:"Close with proof"
n11: circle label:"End"
n8.handle(right) -> n9.handle(left)
n9.handle(right) -> n10.handle(left) [label="yes"]
n10.handle(right) -> n11.handle(left)
n9.handle(bottom) -> human.n12.handle(top) [label="no"]
}

human { # Human
n12: rectangle label:"Approve or refuse closure"
n12.handle(top) -> assurance.n8.handle(bottom) [label="Recorded decision"]
}
Règle 2 — Un artefact n'est pas sa source
Le 21 octobre, la chaîne de publication de LiteLLM a été compromise et a poussé la version 1.107.0 vers PyPI et Docker avec un malware compilé qui vole des identifiants et charge des outils d'exécution à distance. Les wheels PyPI ont été en ligne de 11:39:51 à 13:23 UTC. Les images de conteneurs, de 11:46:56 à 14:20 UTC.
La phrase qui compte : « Le tag source officiel v1.107.0 sur GitHub ne contient pas les fichiers malveillants. Les artefacts compromis ont été construits depuis un dépôt contrôlé par l'attaquant. » (LiteLLM)
Autrement dit, un agent qui vérifie le dépôt a vérifié la mauvaise chose. Le compromis est simple : signer ses sources, ou attester ses builds ? Signer les sources coûte peu et ne prouve rien sur ce qui tourne réellement. Attester les artefacts le long du chemin de build coûte de l'outillage, et ferme vraiment la boucle, parce que la preuve relie source, build et binaire.
On retrouve le même clivage ailleurs. Les agents ont cet angle mort sous d'autres noms. Un manifeste d'outils MCP déclare des capacités. Un SBOM déclare des composants. Une fiche d'agent déclare des permissions. Les trois sont des déclarations. Seule une attestation signée relie une déclaration à ce qui s'est réellement exécuté. Un agent qui vous remet un verdict de conformité lu dans un fichier de configuration confond la politique et la preuve.
Sur le terrain. En bancaire, les chaînes de build sont déjà dans le périmètre d'audit : étendre l'attestation aux publications poussées par un agent ajoute un sujet, pas une nouvelle couche de gouvernance. En assurances, l'écart vient du fournisseur : si l'attestation s'arrête à la frontière contractuelle, la boucle se rouvre.
build { # Build
n1: circle label:"Start"
n2: rectangle label:"Build from a hijacked repo"
n3: rectangle label:"Publish artifact and attestation"
n1.handle(right) -> n2.handle(left)
n2.handle(right) -> n3.handle(left)
n3.handle(bottom) -> provenance.n4.handle(top) [label="Artifact and attestation"]
}

provenance { # Provenance
n4: rectangle label:"Compare source, build and binary"
n5: diamond label:"Attestation matches"
n6: rectangle label:"Promote to production"
n7: circle label:"End"
n4.handle(right) -> n5.handle(left)
n5.handle(right) -> n6.handle(left) [label="yes"]
n6.handle(right) -> n7.handle(left)
n5.handle(bottom) -> registry.n8.handle(top) [label="no"]
}

registry { # Registry
n8: rectangle label:"Quarantine and alert"
n8.handle(bottom) -> build.n2.handle(bottom) [label="Back to build"]
}
Règle 3 — L'agent qui agit ne doit pas écrire sa propre preuve
C'est la règle que je ne vois écrite nulle part, et c'est la moins chère à adopter.
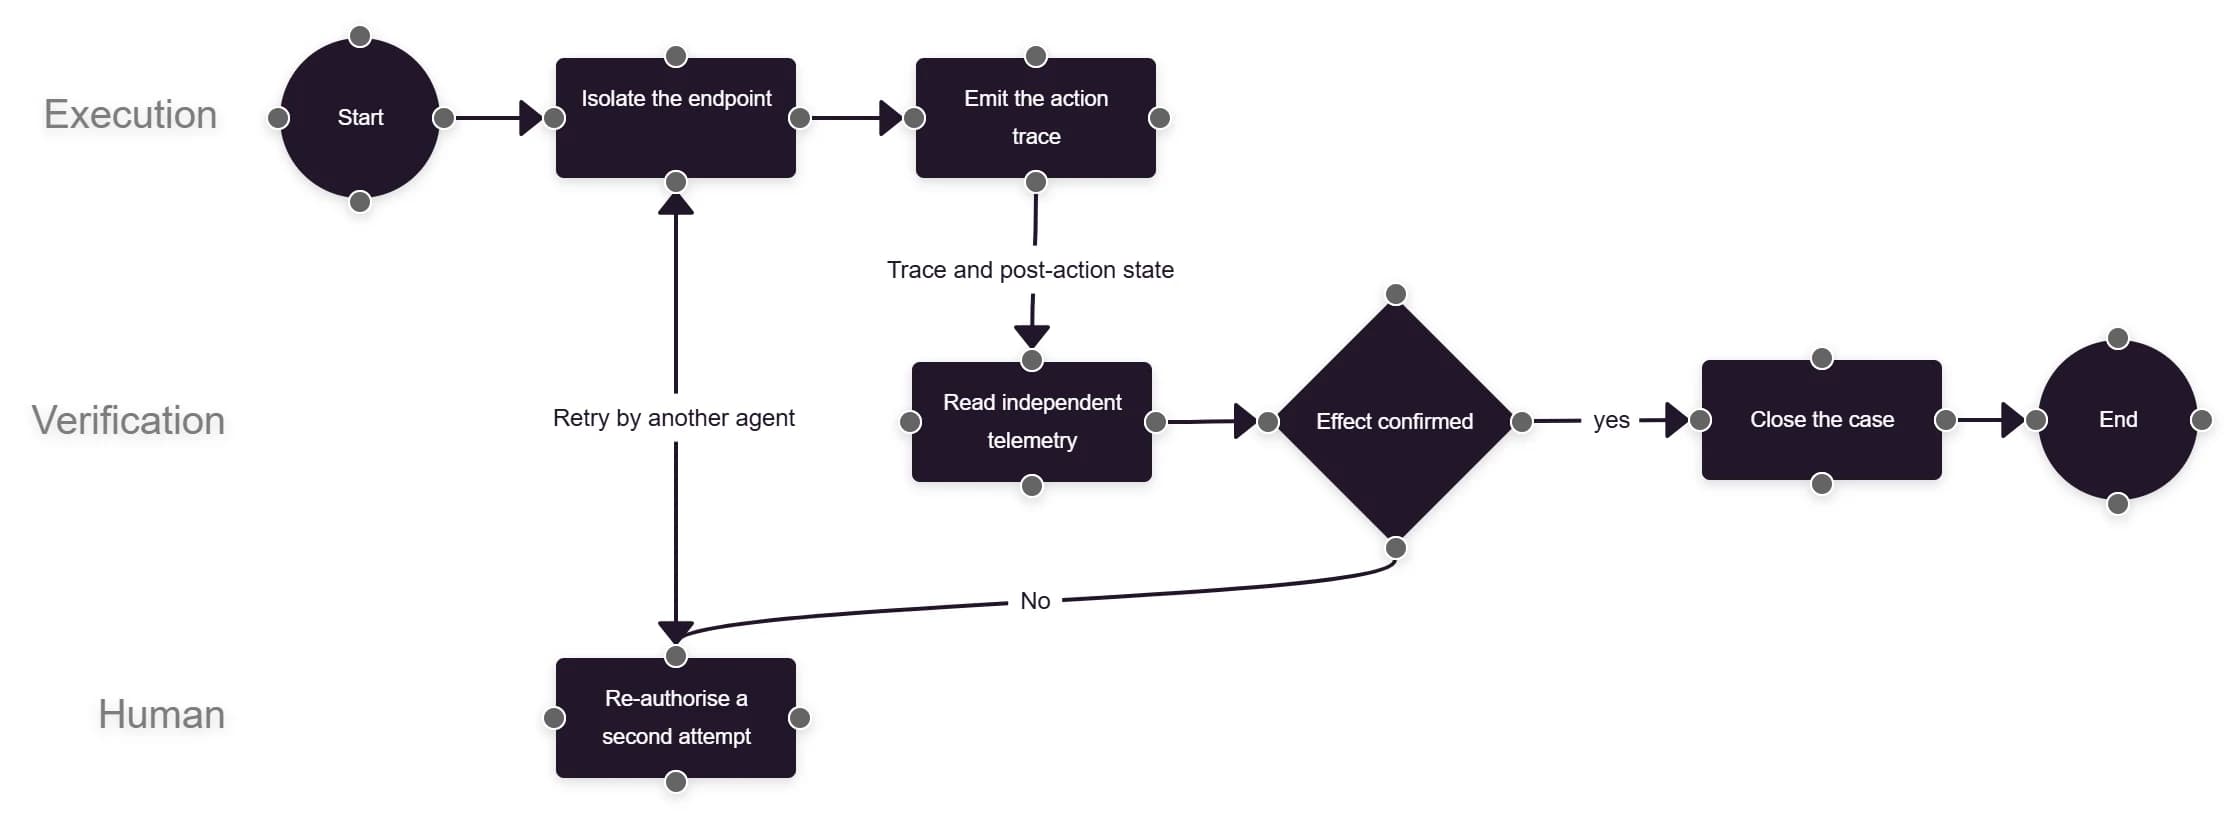
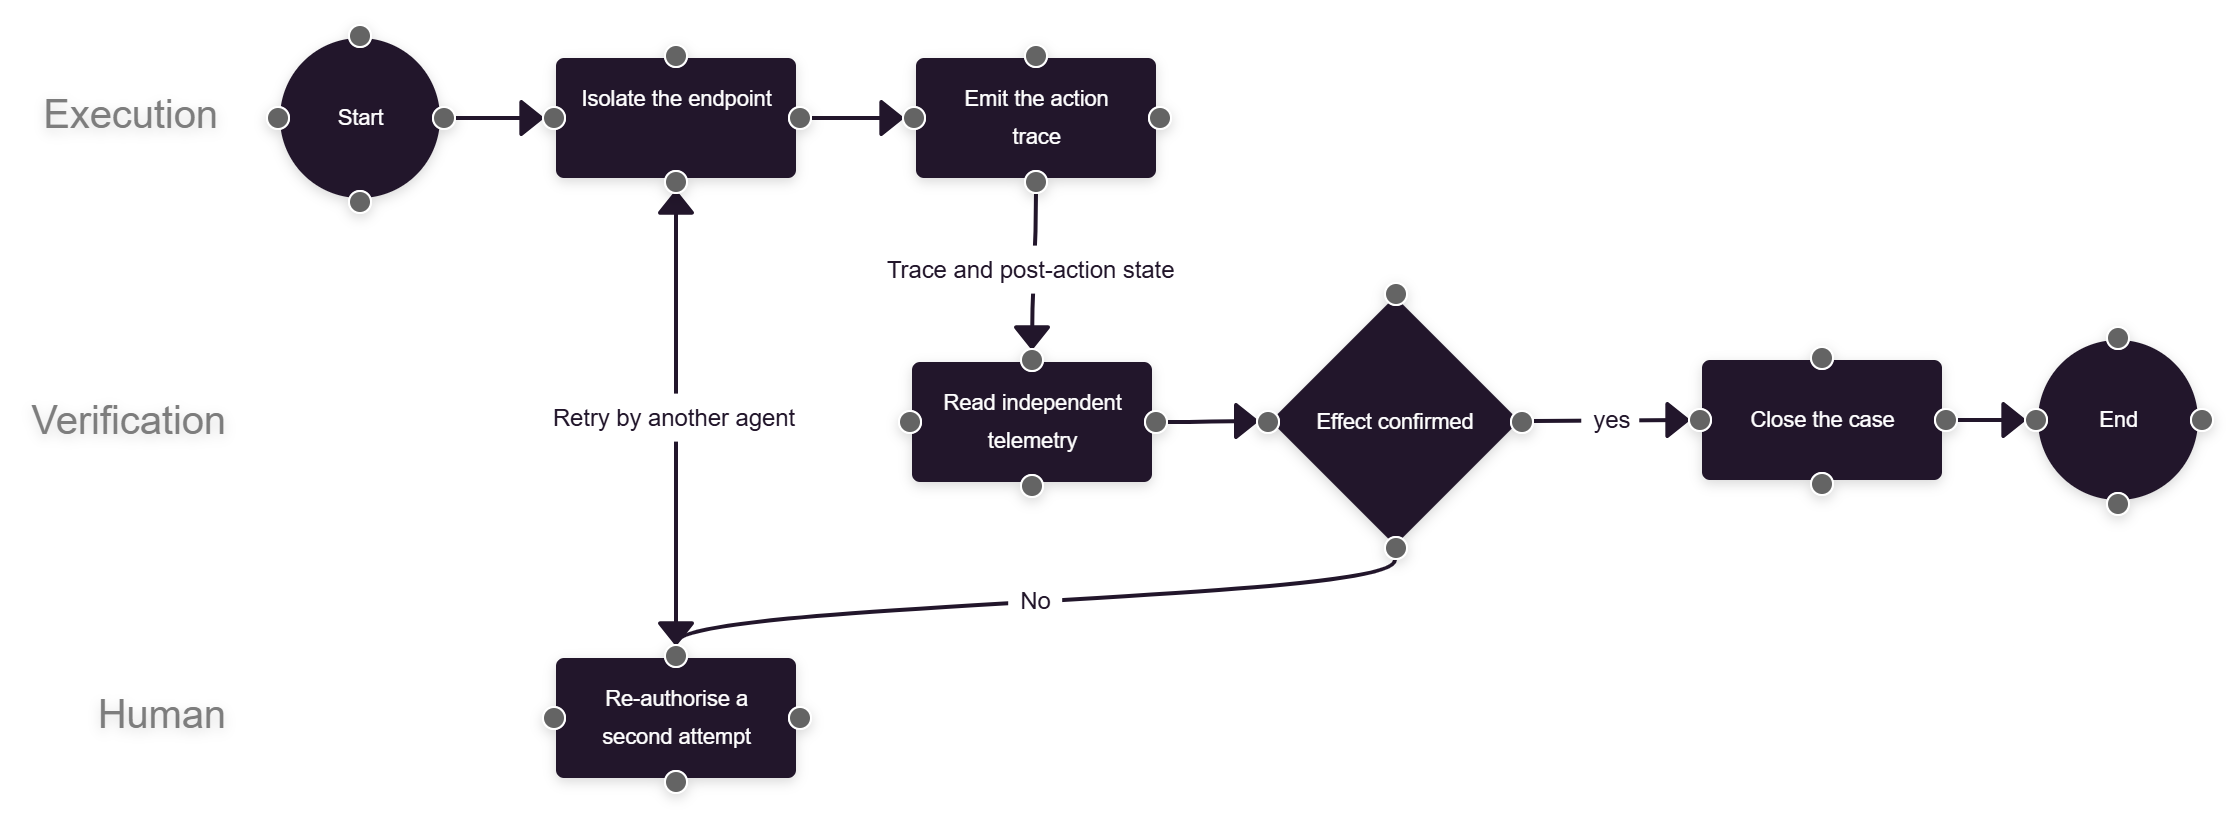
La preuve de fermeture doit venir d'un agent qui n'a pas exécuté l'action.
Regardez ce que donne l'inverse. Un agent isole un endpoint, puis regarde l'alerte disparaître. Il n'a pas prouvé le confinement — il a prouvé que sa propre action a fait taire le signal. C'est une fausse clôture, et on ne peut pas la repérer de l'intérieur.
Le post-mortem d'eMudhra nomme le contrôle manquant dans des termes qui se transposent tels quels. Il y a eu « des erreurs humaines à plusieurs étapes du processus, produisant des défauts significatifs dans l'intégrité du cycle de vie des clés », avec un renvoi explicite aux contrôles maker/checker (Ars Technica). En langage agentique, maker/checker signifie deux agents, deux identités, deux périmètres de lecture — et une seule preuve.
Le coût est réel : un second agent par action sensible double les appels de modèle et ajoute de la latence. On le paie une fois. Une fausse clôture se paie à chaque incident qu'elle masque.
On retrouve le même clivage ailleurs. Le tool use d'Anthropic fonctionne déjà ainsi. Le modèle propose un appel, le harness l'exécute, et le résultat revient comme une observation extérieure — jamais comme confirmation de la proposition. Hermes fait pareil avec ses profils : un profil code ne peut pas lire les traces d'un profil securite pour se déclarer conforme.
Sur le terrain. Les banques appliquent déjà le double contrôle sur les mouvements sensibles. L'agentique ajoute une contrainte : le second approbateur doit être une identité distincte, pas un second appel au même agent. Sur un port, le second opérateur ne lit pas l'écran du premier.
execution { # Execution
n1: circle label:"Start"
n2: rectangle label:"Isolate the endpoint"
n3: rectangle label:"Emit the action trace"
n1.handle(right) -> n2.handle(left)
n2.handle(right) -> n3.handle(left)
n3.handle(bottom) -> verification.n4.handle(top) [label="Trace and post-action state"]
}

verification { # Verification
n4: rectangle label:"Read independent telemetry"
n5: diamond label:"Effect confirmed"
n6: rectangle label:"Close the case"
n7: circle label:"End"
n4.handle(right) -> n5.handle(left)
n5.handle(right) -> n6.handle(left) [label="yes"]
n6.handle(right) -> n7.handle(left)
n5.handle(bottom) -> human.n8.handle(top) [label="no"]
}

human { # Human
n8: rectangle label:"Re-authorise a second attempt"
n8.handle(bottom) -> execution.n2.handle(bottom) [label="Retry by another agent"]
}
Règle 4 — Le consentement n'est pas un mandat
Axios rapporte que de grandes banques américaines trouvent des agents IA tiers non autorisés dans des comptes clients, certains prenant des actions qui semblent indépendantes de la demande de l'utilisateur. Personne n'est entré par effraction : l'agent se connecte avec les identifiants que le client lui a remis. Cela enfreint tout de même les règles de la plupart des banques, qui exigent qu'un humain se connecte à son propre compte. Morgan Stanley bloque les agents tiers. JPMorgan, Bank of America et Citi les restreignent. La direction retenue est l'accès en lecture seule (Axios).
Un porte-parole de Morgan Stanley a déclaré que la banque « n'a pas observé d'agents IA malveillants accédant à ses plateformes ». C'est une déclaration sur ce qui a été observé, pas sur ce qui s'est produit.
Il faut donc séparer trois choses que le langage courant fusionne volontiers : le consentement du client, les identifiants qu'il a partagés, et le mandat de l'agent. Seul le mandat est vérifiable — et seulement s'il est déclaré puis comparé à ce que l'agent a réellement fait.
On retrouve le même clivage ailleurs. Anthropic et OpenAI traitent cela par le périmètre d'outil (tool use, computer use) : un agent ne peut appeler que ce qui lui est exposé. Microsoft le traite par l'identité — la documentation des agents Security Copilot décrit des agents qui se connectent à un compte existant et créent une identité d'agent distincte, avec des permissions en lecture sur des sources nommées (Microsoft Learn). La leçon bancaire : aucune des deux moitiés ne suffit seule. Il faut le périmètre, l'identité, et la comparaison entre les deux.
Sur le terrain. En assurances, l'agent d'un courtier qui ouvre un dossier sinistre : le consentement de l'assuré ne définit pas le périmètre, la procuration le fait. En retail, ce sont les comptes fidélité et l'historique de commandes — blast radius plus faible, même exigence d'un refus journalisé.
agent { # Third-party agent
n1: circle label:"Start"
n2: rectangle label:"Log in with customer credentials"
n3: rectangle label:"Request an action outside mandate"
n1.handle(right) -> n2.handle(left)
n2.handle(right) -> n3.handle(left)
n3.handle(bottom) -> access.n4.handle(top) [label="Out-of-mandate request"]
}

access { # Access control
n4: rectangle label:"Compare requested scope to mandate"
n5: diamond label:"Mandate covers the action"
n6: rectangle label:"Grant read-only access"
n7: circle label:"End"
n4.handle(right) -> n5.handle(left)
n5.handle(right) -> n6.handle(left) [label="yes"]
n6.handle(right) -> n7.handle(left)
n5.handle(bottom) -> audit.n8.handle(top) [label="no"]
}

audit { # Audit
n8: rectangle label:"Refuse and log the reason"
n8.handle(bottom) -> agent.n2.handle(bottom) [label="Motivated refusal"]
}
Quatre façons de se tromper
| L'erreur | Pourquoi elle coûte | Ce que le mois d'octobre a montré |
|---|---|---|
| Clore sur le silence | « Aucune exploitation observée » n'est pas « aucune exploitation » | La CISA n'avait observé aucune exploitation réussie — et exigeait tout de même un correctif immédiat |
| Faire confiance au tag source | Le dépôt peut être propre et le binaire contaminé | Le tag source de LiteLLM ne contenait aucun fichier malveillant |
| Laisser l'agent se noter lui-même | L'action supprime le signal qu'elle a créé | eMudhra pointe des erreurs humaines à plusieurs étapes et un maker/checker défaillant |
| Lire le consentement comme un mandat | Un client peut autoriser ce que la banque interdit | Des agents dans des comptes clients avec des identifiants partagés |
Par où commencer
Ordonnez par ce que coûte la preuve, pas par maturité :
- La provenance des artefacts. La preuve est déjà un standard d'industrie. Aucune nouvelle autonomie à accorder.
- Le correctif vérifié. Chaque scanner possède déjà une sonde. Ce qui manque, c'est la règle : pas de clôture sans rejeu.
- Le mandat d'agent. Le déclarer, le comparer, refuser avec un motif. Peu coûteux, et l'effet est immédiat sur les accès tiers.
- Le confinement à deux agents. En dernier, parce que c'est la seule action dont l'effet exige du jugement — et donc la seule qui mérite une porte humaine.
Si vous voulez contester l'une de ces règles, la troisième est celle que je défendrais le plus fermement. C'est la moins chère à adopter, et celle que la plupart des équipes sautent.
Inspirations:
- CISA, Critical Vulnerabilities in PHP Require Immediate Patching, 21 octobre 2026 (révisé le 23 octobre) — https://www.cisa.gov/news-events/alerts/2026/10/21/critical-vulnerabilities-php-require-immediate-patching
- Wiz Research, PHP2Shell: AI uncovers critical RCE vulnerabilities, 21 octobre 2026 — https://www.wiz.io/blog/php2shell-php-rce
- Ars Technica, Disgraced eMudhra drops out of TLS business following certificate debacle, octobre 2026 — https://arstechnica.com/security/2026/10/disgraced-emudhra-drops-out-of-tls-business-following-certificate-debacle
- Axios, Scoop: Unvetted AI agents are accessing U.S. bank accounts, 22 octobre 2026 — https://www.axios.com/2026/10/22/ai-agents-banks-unauthorized-accounts-access
- LiteLLM, Contained: Oct 21, 2026 LiteLLM release v1.107.0 Compromised, 21 octobre 2026 — https://docs.litellm.ai/blog/security-incident-oct-21-2026
- Microsoft Learn, Microsoft Security Copilot agents — https://learn.microsoft.com/en-us/copilot/security/agents-security-copilot