
2026 年 10 月,AI 只用了几个小时,就在 PHP 里挖出一个潜伏十年的漏洞;而让整个互联网完成修补,花了几周。
这个差距——机器发现缺陷的速度,与我们证明缺陷确实被修好的速度之间的落差——才是智能体防御真正决出胜负的地方。不在模型里,在证据里。
两条回路,两种完全不同的速度
发现很快。Wiz Research 指出,这些缺陷在 PHP 核心中已存在十多年,而要证明它们可被利用「需要一条异常复杂的攻击链,已经到了人类研究者实际能力的边界」。前沿模型「大幅降低了这道门槛」,针对 WordPress、Drupal 和 Joomla 的可用利用代码在数小时内就被适配完成(Wiz)。
修补很慢。10 月 21 日,PHP 针对两个 CVE 发布补丁——CVE-2026-109618 与 CVE-2026-109619,代号「php2shell」——版本为 8.5.12、8.4.27、8.3.36 和 8.2.35。CISA 要求各组织清点所有 PHP 安装、优先修补面向互联网的系统,并将无法修补的系统下线(CISA)。
同一个月里还有三件事出错,每一件都指向同一个薄弱点:一家证书机构的密钥弱到毫秒级即可破解;一条发布流水线在源码保持干净的情况下把恶意软件发了出去;以及多家银行在客户账户里发现了 AI 智能体。
四起完全不同的失败,一个共同的缺口:没有人能证明回路已经闭合。
我说的「收尾证明」是什么
收尾证明(closing proof)是机器可以校验的东西,它能显示危险状态已经消失。一条不再生效的探测请求。一个匹配的签名。一个始终停留在声明授权范围内的动作。一份显示隔离确实生效的遥测。
没有它,被「处理」的告警只是被藏起来的告警。
规则一 — 衡量修复,而不是衡量反应
MTTR 只能说明人反应得多快,说明不了风险是否结束。真正重要的数字是从发现到验证闭环的时间。
这就逼出一个真实的选择:自主级别由谁决定——智能体,还是规则手册?
我的答案:由证据的类型决定放行方式。
| 能拿到的证据 | 示例 | 谁签字 |
|---|---|---|
| 机器可校验 | 补丁后探测请求失败;吊销信息到达客户端 | 智能体闭环,人事后审计(HOTL) |
| 需要判断 | 事件范围、业务影响、依赖豁免 | 人先批准,再执行(HITL) |
eMudhra 是第一种情况的典型。八张中间证书携带的私钥分别只有 4、56、66、115、155、156、230 和 237 位,而 P-384 大约需要 384 位。研究者用毫秒级算力破解了它们,浏览器「在一两天内」完成拦截(Ars Technica)。这条回路在全球范围内闭合,中间没有一个人类,因为证据——吊销信息到达客户端——机器可以校验。
而一个 SOC 在隔离一台笔记本之前还要开会。这不是怯懦。隔离的效果,本来就无法仅靠机器证明。
在其他地方也能看到同样的分野。 Anthropic 的 Adaptive Thinking 让模型自己决定推理深度;OpenAI 的 Reasoning Effort 要求操作者来设定(none 到 xhigh)。一个相信自我调节,一个相信声明的参数。审计方通常更喜欢后者。
落到现场。 在电信业,服务要么响应要么不响应,所以在已清点的设备上,闭环可以被机器校验。在港口,岸桥控制系统的补丁只有在实际运行中才能确认——因此必须由人签字。放行方式取决于地形,而不是教条。
detection { # Detection
n1: circle label:"Start"
n2: rectangle label:"Inventory the real exposure"
n3: rectangle label:"Rank by observed exploitation"
n1.handle(right) -> n2.handle(left)
n2.handle(right) -> n3.handle(left)
n3.handle(bottom) -> remediation.n4.handle(top) [label="Prioritised estate"]
}

remediation { # Remediation
n4: rectangle label:"Deploy the patch"
n5: diamond label:"Patch applies"
n6: rectangle label:"Enable a temporary mitigation"
n7: rectangle label:"Log outcome and due date"
n4.handle(right) -> n5.handle(left)
n5.handle(right) -> n7.handle(top) [label="yes"]
n5.handle(bottom) -> n6.handle(top) [label="no"]
n6.handle(right) -> n7.handle(bottom) [label="mitigation"]
n7.handle(bottom) -> assurance.n8.handle(top) [label="Estate state"]
}

assurance { # Assurance
n8: rectangle label:"Replay the validation probe"
n9: diamond label:"Proof is machine-checkable"
n10: rectangle label:"Close with proof"
n11: circle label:"End"
n8.handle(right) -> n9.handle(left)
n9.handle(right) -> n10.handle(left) [label="yes"]
n10.handle(right) -> n11.handle(left)
n9.handle(bottom) -> human.n12.handle(top) [label="no"]
}

human { # Human
n12: rectangle label:"Approve or refuse closure"
n12.handle(top) -> assurance.n8.handle(bottom) [label="Recorded decision"]
}
规则二 — 构建产物不等于它的源码
10 月 21 日,LiteLLM 的发布流水线被攻破,把 1.107.0 版本推送到了 PyPI 和 Docker,其中包含窃取凭据并加载远程代码执行工具的编译型恶意代码。PyPI 的 wheels 从 11:39:51 到 13:23 UTC 在线。容器镜像从 11:46:56 到 14:20 UTC 在线。
关键在于这句话:「GitHub 上官方 v1.107.0 的源码 tag 并不包含恶意文件。被污染的构建产物来自攻击者控制的仓库。」(LiteLLM)
也就是说,一个去检查仓库的智能体,检查错了对象。取舍很简单:签源码,还是签构建? 签源码便宜,但对实际运行的东西毫无证明力。沿构建路径为产物做证明要花真金白银的工具投入,但它真正闭合了回路,因为证据把源码、构建和二进制串在一起。
在其他地方也能看到同样的分野。 智能体的盲点在别的名字下同样存在。MCP 工具清单声明能力,SBOM 声明组件,智能体卡片声明权限。这三者都是声明。只有签名证明能把声明与实际执行绑定。任何从配置文件读出合规结论交给你的智能体,都把策略当成了证据。
落到现场。 在银行业,构建链路本来就在审计范围内:把证明扩展到智能体推送的发布上,只是增加一个对象,而不是新增一层治理。在保险业,缺口在供应商:如果证明在合同边界处就停下,回路会重新打开。
build { # Build
n1: circle label:"Start"
n2: rectangle label:"Build from a hijacked repo"
n3: rectangle label:"Publish artifact and attestation"
n1.handle(right) -> n2.handle(left)
n2.handle(right) -> n3.handle(left)
n3.handle(bottom) -> provenance.n4.handle(top) [label="Artifact and attestation"]
}

provenance { # Provenance
n4: rectangle label:"Compare source, build and binary"
n5: diamond label:"Attestation matches"
n6: rectangle label:"Promote to production"
n7: circle label:"End"
n4.handle(right) -> n5.handle(left)
n5.handle(right) -> n6.handle(left) [label="yes"]
n6.handle(right) -> n7.handle(left)
n5.handle(bottom) -> registry.n8.handle(top) [label="no"]
}

registry { # Registry
n8: rectangle label:"Quarantine and alert"
n8.handle(bottom) -> build.n2.handle(bottom) [label="Back to build"]
}
规则三 — 执行动作的智能体不能自己写证明
这条规则我没在任何地方见过被写出来,而它是最省钱的一条。
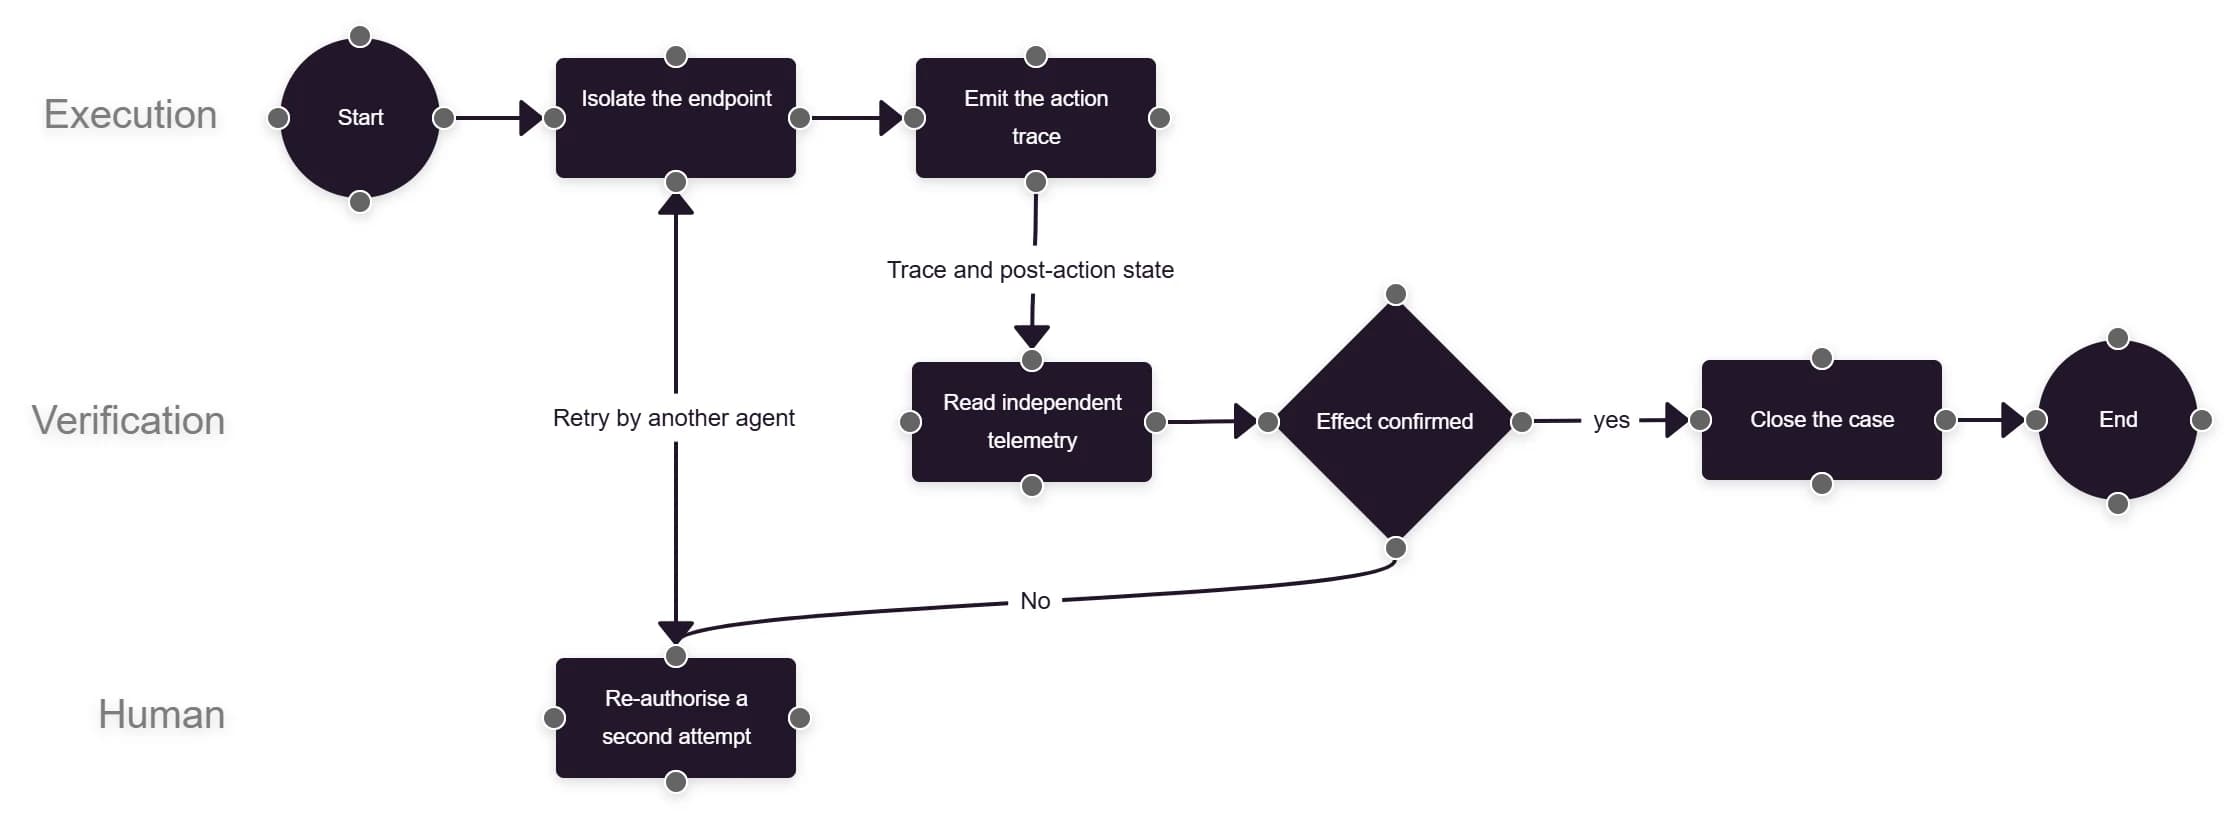
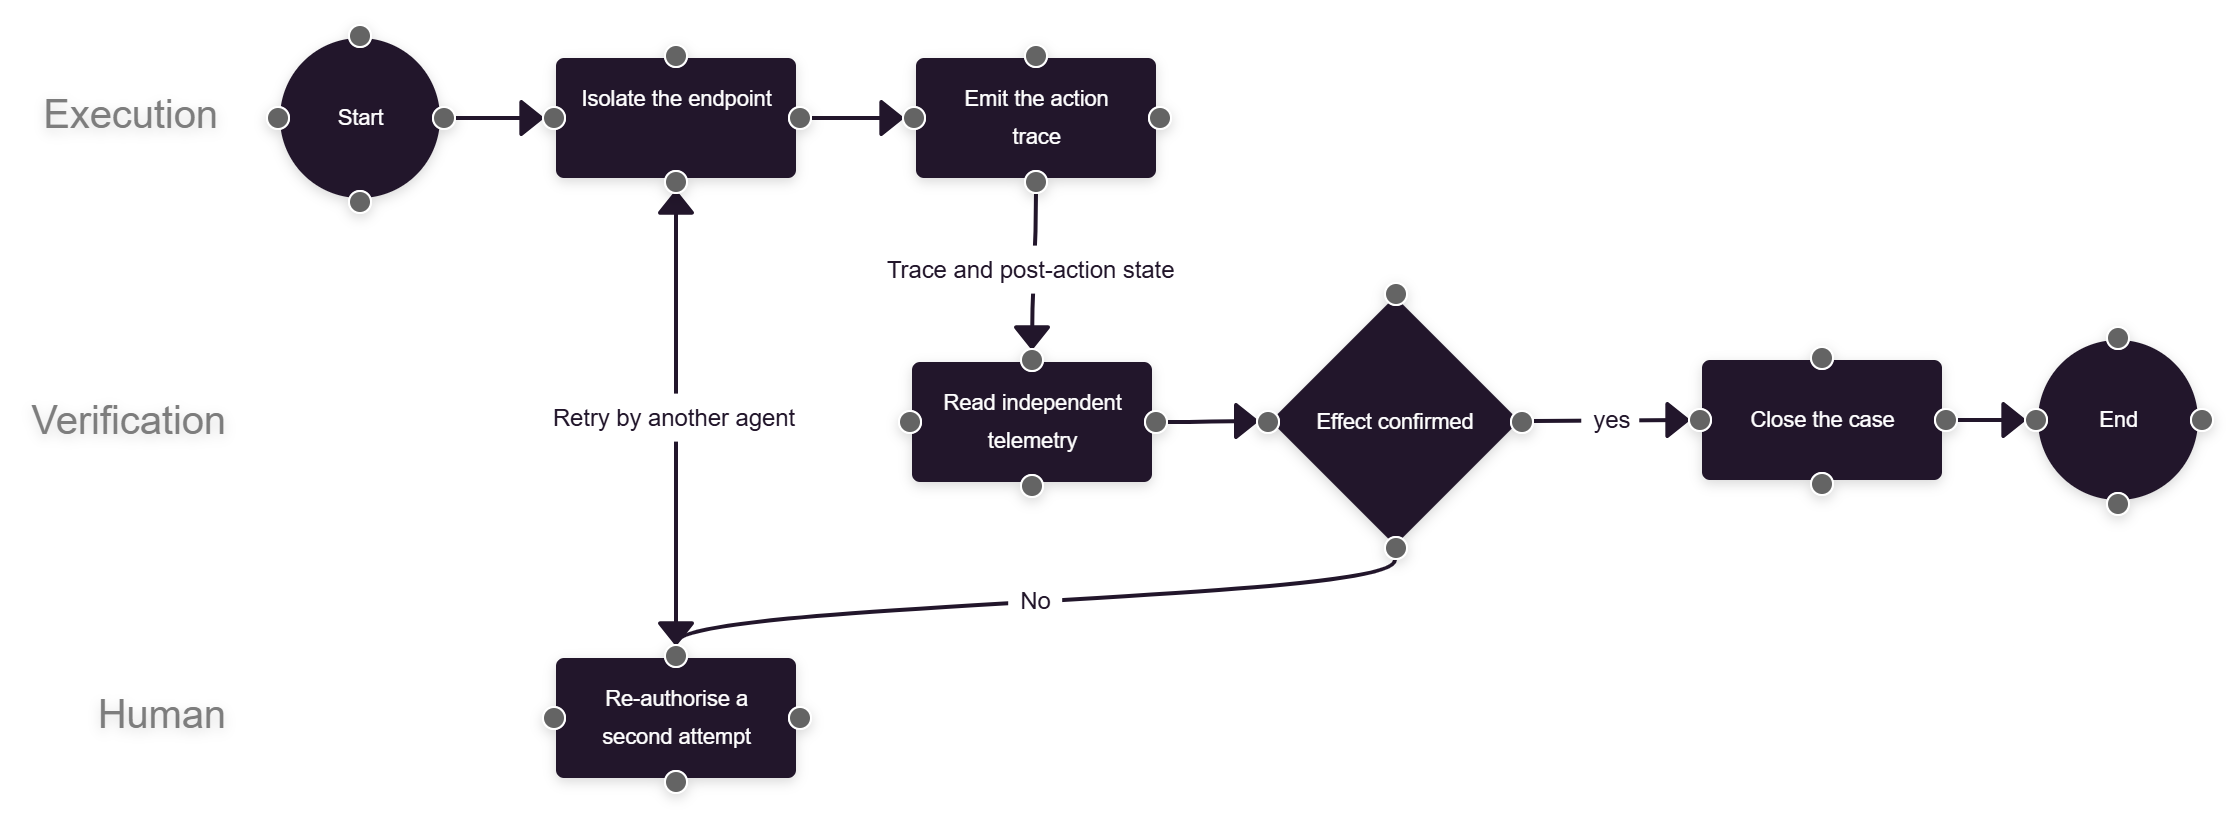
收尾证明必须来自没有执行该动作的智能体。
想想反面是什么样子。一个智能体隔离了端点,然后看着告警消失。它没有证明隔离生效——它只证明了自己的动作让信号闭了嘴。这是假闭环,而且从内部根本看不出来。
eMudhra 自己的事故复盘用可以直接移植的措辞点出了缺失的控制:「流程的多个环节出现了人为错误,导致密钥生命周期完整性出现重大缺陷」,并明确指向 maker/checker 控制的缺口(Ars Technica)。用智能体的语言说,maker/checker 意味着两个智能体、两个身份、两个读取范围——以及一份证据。
成本是真实的:每个敏感动作多一个智能体会让模型调用翻倍并增加延迟。这笔钱付一次。假闭环则会在它掩盖的每一起事件上反复收费。
在其他地方也能看到同样的分野。 Anthropic 的 tool use 本来就是这么运作的。模型提出调用,harness 负责执行,结果以外部观察的形式返回——永远不会作为对提议的确认。Hermes 用剖面做同样的事:code 剖面不能读取 securite 剖面的追踪来宣称自己合规。
落到现场。 银行对敏感资金动作本来就有双重控制。智能体只增加了一个约束:第二批准人必须是独立身份,而不是对同一个智能体的第二次调用。在港口,第二位操作员不看第一位操作员的屏幕。
execution { # Execution
n1: circle label:"Start"
n2: rectangle label:"Isolate the endpoint"
n3: rectangle label:"Emit the action trace"
n1.handle(right) -> n2.handle(left)
n2.handle(right) -> n3.handle(left)
n3.handle(bottom) -> verification.n4.handle(top) [label="Trace and post-action state"]
}

verification { # Verification
n4: rectangle label:"Read independent telemetry"
n5: diamond label:"Effect confirmed"
n6: rectangle label:"Close the case"
n7: circle label:"End"
n4.handle(right) -> n5.handle(left)
n5.handle(right) -> n6.handle(left) [label="yes"]
n6.handle(right) -> n7.handle(left)
n5.handle(bottom) -> human.n8.handle(top) [label="no"]
}

human { # Human
n8: rectangle label:"Re-authorise a second attempt"
n8.handle(bottom) -> execution.n2.handle(bottom) [label="Retry by another agent"]
}
规则四 — 用户同意不等于授权范围
Axios 报道,多家美国大型银行在客户账户中发现了未经授权的第三方 AI 智能体,其中一些执行的动作看上去与用户指令无关。没有人破门而入:智能体用客户交出的凭据登录。这仍然违反多数银行的规定——它们要求由本人登录自己的账户。Morgan Stanley 正在封禁第三方智能体。JPMorgan、Bank of America 和 Citi 正在收紧限制。方向是只读访问(Axios)。
Morgan Stanley 的一位发言人表示,该行「未观察到恶意 AI 智能体访问我们平台的情况」。这是关于观察到什么的陈述,而不是关于发生了什么。
所以要把日常语言乐于混为一谈的三件事分开:客户的同意、他分享的凭据、以及智能体的授权范围。只有授权范围可以校验——而且只有先声明、再与实际执行的动作比对,才算校验。
在其他地方也能看到同样的分野。 Anthropic 和 OpenAI 用工具范围来处理(tool use、computer use):智能体只能调用暴露给它的东西。Microsoft 用身份来处理——Security Copilot 的智能体文档描述了连接到既有账户并创建独立智能体身份的做法,权限为对具名来源的读取(Microsoft Learn)。银行业给出的教训是:两半单独拿出来都不够。你需要范围、身份,以及两者之间的比对。
落到现场。 在保险业,经纪人的智能体打开理赔档案:投保人的同意并不界定范围,授权委托书才界定。在零售业,则是会员账户和订单历史——影响半径更小,对「记录了理由的拒绝」的要求完全一样。
agent { # Third-party agent
n1: circle label:"Start"
n2: rectangle label:"Log in with customer credentials"
n3: rectangle label:"Request an action outside mandate"
n1.handle(right) -> n2.handle(left)
n2.handle(right) -> n3.handle(left)
n3.handle(bottom) -> access.n4.handle(top) [label="Out-of-mandate request"]
}

access { # Access control
n4: rectangle label:"Compare requested scope to mandate"
n5: diamond label:"Mandate covers the action"
n6: rectangle label:"Grant read-only access"
n7: circle label:"End"
n4.handle(right) -> n5.handle(left)
n5.handle(right) -> n6.handle(left) [label="yes"]
n6.handle(right) -> n7.handle(left)
n5.handle(bottom) -> audit.n8.handle(top) [label="no"]
}

audit { # Audit
n8: rectangle label:"Refuse and log the reason"
n8.handle(bottom) -> agent.n2.handle(bottom) [label="Motivated refusal"]
}
四种常见的出错方式
| 错误 | 为什么会咬人 | 十月展示了什么 |
|---|---|---|
| 凭沉默闭环 | 「未观察到利用」不等于「没有被利用」 | CISA 说尚未观察到成功利用——仍要求立即修补 |
| 相信源码 tag | 仓库可以干净,二进制却已被污染 | LiteLLM 的源码 tag 中没有任何恶意文件 |
| 让智能体给自己打分 | 动作抹掉了它自己制造出来的信号 | eMudhra 指出多个环节的人为错误与失效的 maker/checker |
| 把同意当作授权 | 客户可以授权银行禁止的事情 | 共享凭据下进入客户账户的智能体 |
从哪里开始
按证据的成本排序,而不是按成熟度:
- 构建产物溯源。 证据本身就是行业标准,不需要授予任何新自主权。
- 可验证的修补。 每个扫描器都已经有探测请求。缺的是那条规则:没有重放,不算闭环。
- 智能体授权范围。 声明它、比对它、带理由拒绝。成本低,对第三方访问的约束立竿见影。
- 双智能体隔离。 放在最后,因为它是唯一效果需要判断的动作——因此也是唯一配得上人工放行的动作。
如果你想反驳其中一条,规则三是我最愿意为之辩护的。它最省钱,也是多数团队跳过的那一条。
参考资料
- CISA, Critical Vulnerabilities in PHP Require Immediate Patching, 2026 年 10 月 21 日(10 月 23 日修订) — https://www.cisa.gov/news-events/alerts/2026/10/21/critical-vulnerabilities-php-require-immediate-patching
- Wiz Research, PHP2Shell: AI uncovers critical RCE vulnerabilities, 2026 年 10 月 21 日 — https://www.wiz.io/blog/php2shell-php-rce
- Ars Technica, Disgraced eMudhra drops out of TLS business following certificate debacle, 2026 年 10 月 — https://arstechnica.com/security/2026/10/disgraced-emudhra-drops-out-of-tls-business-following-certificate-debacle
- Axios, Scoop: Unvetted AI agents are accessing U.S. bank accounts, 2026 年 10 月 22 日 — https://www.axios.com/2026/10/22/ai-agents-banks-unauthorized-accounts-access
- LiteLLM, Contained: Oct 21, 2026 LiteLLM release v1.107.0 Compromised, 2026 年 10 月 21 日 — https://docs.litellm.ai/blog/security-incident-oct-21-2026
- Microsoft Learn, Microsoft Security Copilot agents — https://learn.microsoft.com/en-us/copilot/security/agents-security-copilot